Del hospital que trata al sistema que anticipa: lo que la transformación digital le exige a la gestión sanitaria
29/10/2026Crónica de congreso · IHMC 2026
De la capacidad al valor: qué necesita una clínica para que la inteligencia artificial mejore la atención
Los modelos de inteligencia artificial ya igualan o superan a los especialistas en tareas acotadas. Sin embargo, casi no se notan en los hospitales. Una conferencia sobre el estado del arte en 2026 explicó por qué, y sus mejores ejemplos apuntan al mismo lugar: la distancia entre una herramienta que funciona y una intervención que mejora la atención se recorre con decisiones de gestión.
Pregunta central
¿Qué necesita una clínica de mediana y alta complejidad para convertir las capacidades de la inteligencia artificial en mejoras reales de atención, seguridad, acceso y operación?
En síntesis
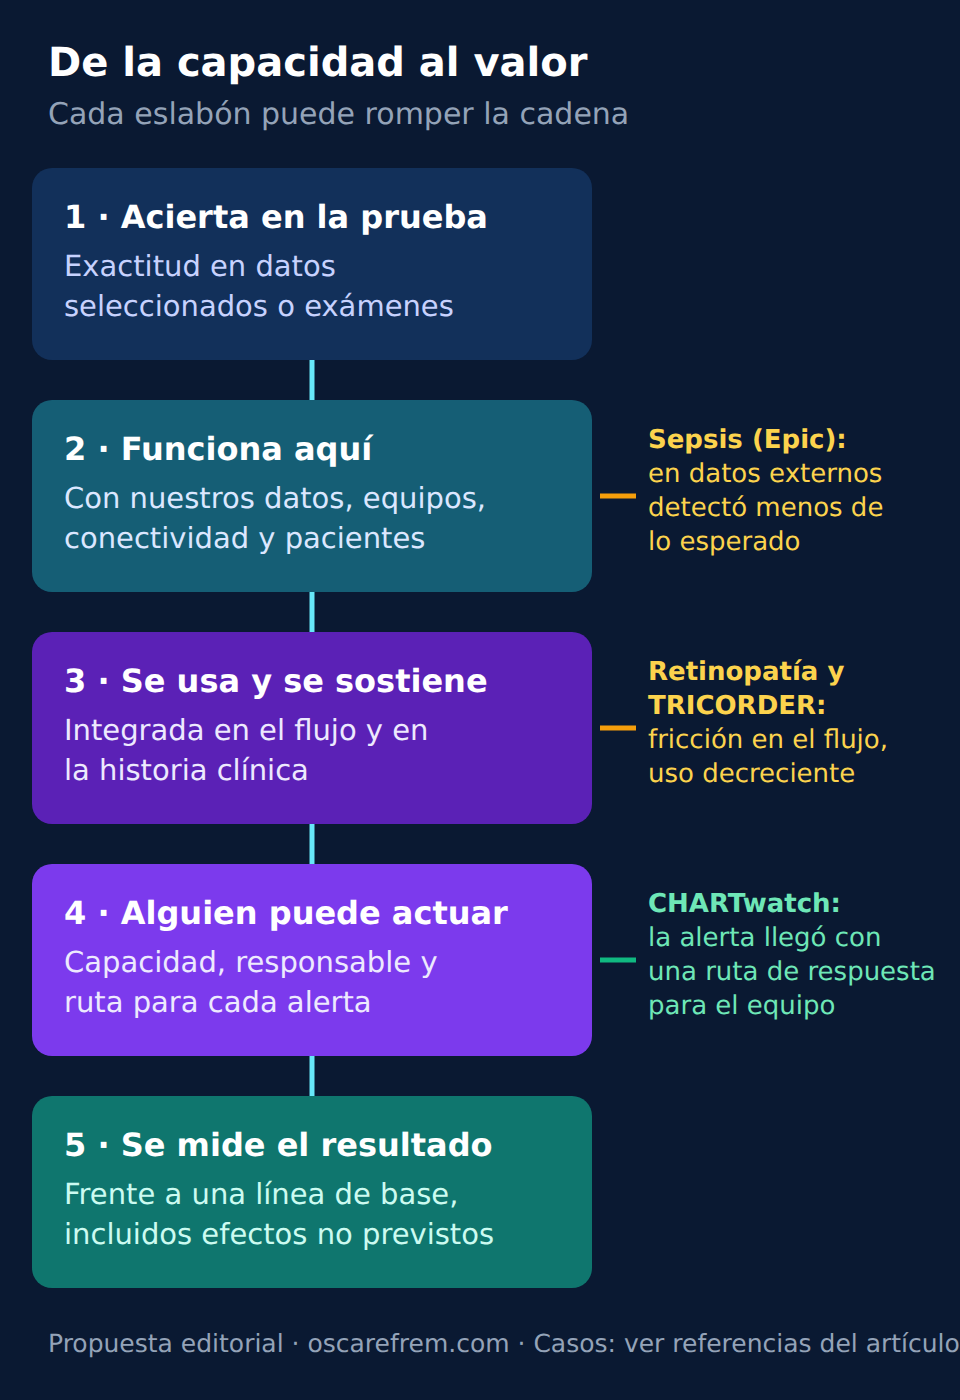
Tesis: la capacidad técnica de la inteligencia artificial (IA) ya no es el principal límite. Lo es la cadena que va del modelo al paciente: un problema bien elegido, integración en el flujo de trabajo, uso sostenido, capacidad para actuar sobre lo que el modelo detecta y medición del resultado. Una herramienta eficaz puede fracasar como intervención si falta cualquiera de esos eslabones.
- Eficacia no es efectividad Un estetoscopio con IA que detecta bien no aumentó los diagnósticos de insuficiencia cardiaca en 205 consultorios británicos, porque su uso decayó.
- Exámenes no son decisiones Los modelos superan el 90 % en preguntas tipo examen, pero rinden menos cuando deben reunir e interpretar la información de un caso real.
- Abierto o cerrado es una decisión de gobierno Los pesos abiertos no implican datos abiertos ni validación clínica, y la desventaja de capacidad cambia con la fecha y la tarea.
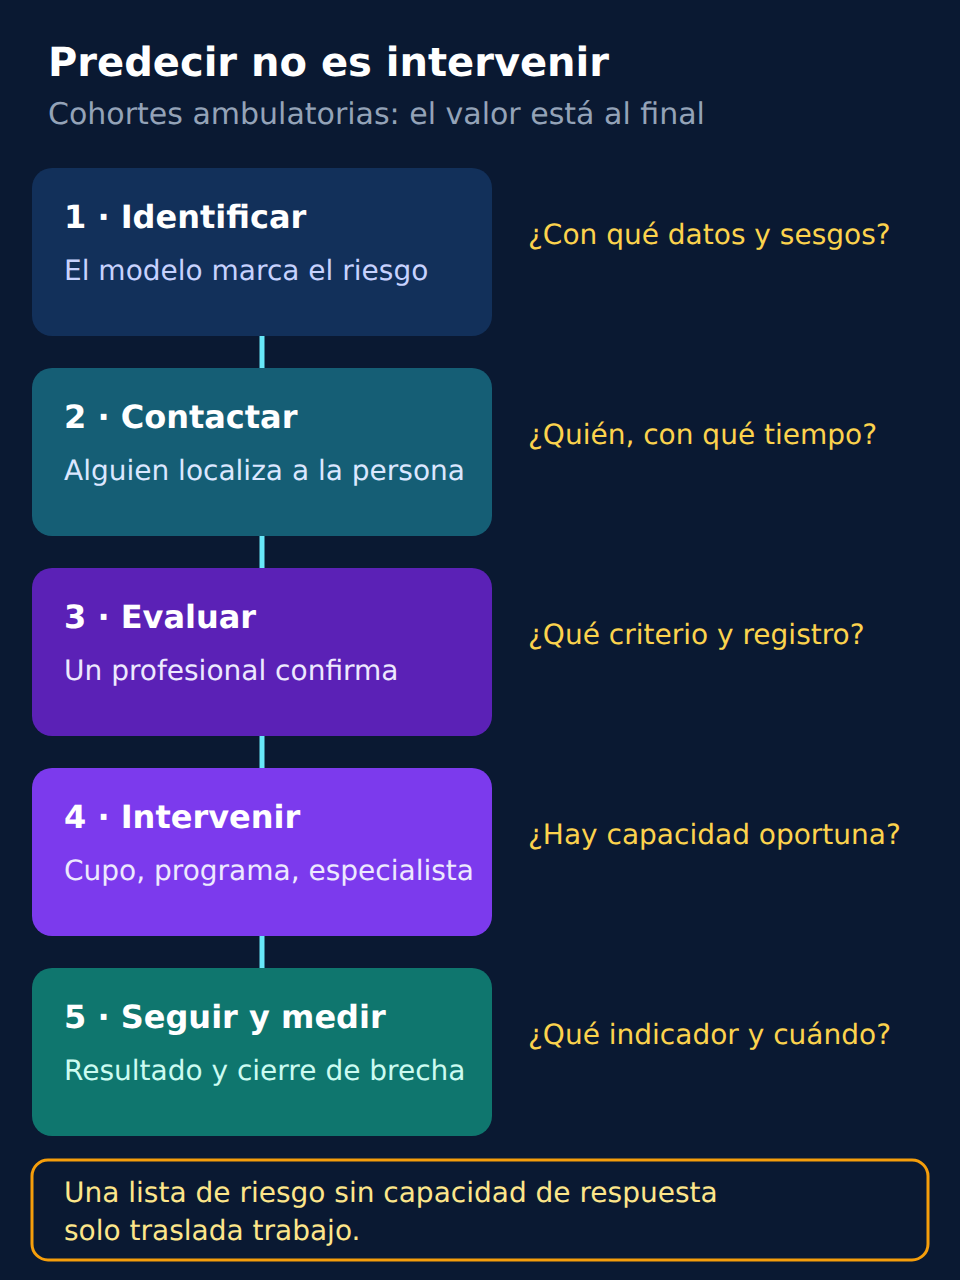
- Predecir no basta En hospitales y en cohortes ambulatorias, una alerta solo aporta valor si existe una respuesta asistencial disponible, oportuna y medible.
Cada semana aparece un modelo de inteligencia artificial que supera una prueba médica más difícil que la anterior. Mientras tanto, en la mayoría de las clínicas, los médicos siguen escribiendo notas a mano o con plantillas, los pacientes esperan una cama sin que nadie sepa con precisión cuándo quedará libre, y las listas de pacientes crónicos sin control se revisan cuando alguien tiene tiempo. La distancia entre lo que la IA puede hacer y lo que efectivamente cambia en la atención es el tema de este artículo.
El punto de partida es una conferencia magistral pronunciada en Corea del Sur. A partir de ella separamos tres planos: lo que planteó el ponente, lo que muestran las fuentes que consultamos y nuestro análisis desde la gestión de operaciones clínicas. La fecha de corte de la investigación es el 29 de octubre de 2026, el mismo día de la charla.
1La conferencia y su pregunta
La sexta International Healthcare & MedTech Conference (IHMC) se celebró el 28 y el 29 de octubre de 2026 en el Healthcare Innovation Park del Seoul National University Bundang Hospital, en Seongnam. La conferencia magistral del segundo día, «AI in Medicine: Where are we in 2026?», estuvo a cargo del profesor Tien Yin Wong, oftalmólogo, vicerrector (Vice-Provost) de la Universidad de Tsinghua y Senior Vice-Chancellor de Tsinghua Medicine. Wong contó que ha ejercido en Singapur, Estados Unidos, Australia y China, y que su camino hacia la IA empezó por la epidemiología clínica y la bioestadística. A los clínicos interesados en la IA les recomendó ese mismo orden: entender primero los datos y cómo se construyen los modelos.

Wong abrió con un marco histórico de «tres revoluciones» en la medicina. La primera, asociada al informe Flexner de 1910, dio a la medicina una base biológica centrada en el médico. La segunda, que vinculó con la comisión de The Lancet sobre la formación de los profesionales de la salud de 2010, amplió la mirada a los equipos y a los determinantes sociales[1]. La tercera es la de la IA: el médico más la IA, en sistemas de salud que el ponente llamó «nativos de IA».
Para ilustrar la segunda revolución, el ponente afirmó que solo alrededor del 20 % de la salud depende del cuerpo y los genes, y el 80 % de factores externos. La idea de fondo está bien respaldada, pero la cifra necesita contexto. Los porcentajes que suelen circular proceden de un modelo de salud poblacional estadounidense, en el que el 20 % corresponde a la atención clínica, no a la biología. Además, son ponderaciones convencionales, no fracciones causales. Una estimación empírica con datos de condados de Estados Unidos atribuyó a la atención clínica el 16 % de la variación en los resultados de salud[2]. El mensaje para la gestión sigue en pie: gran parte de lo que determina la salud ocurre fuera del hospital.
La pregunta que estructuró la charla fue cuál es la «vía traslacional hacia el valor». Wong la desglosó en preguntas que dejó abiertas: cómo formar a los estudiantes, si la IA reemplaza o aumenta al médico, si hace falta una carrera de clínico-científico de IA y cómo construir un sistema de salud diseñado con la IA desde el origen. Terminó con la que más interesa aquí: qué es el valor. ¿Atención mejor, más segura, más accesible?
2Lo que la IA ya hace bien, y en qué condiciones
El ponente situó el inicio de la revolución actual hace unos diez años, con el aprendizaje profundo. Su especialidad ofreció los primeros ejemplos clínicos. En 2016, un equipo de Google publicó en JAMA un algoritmo que detectaba retinopatía diabética en fotografías de fondo de ojo con alta sensibilidad y especificidad, validado en conjuntos de imágenes retrospectivos[3]. En 2017, otro equipo, del que Wong formó parte, validó un sistema similar en poblaciones multiétnicas[4].
Wong describió esos modelos con una analogía útil: son como una calculadora. Nadie supera a una calculadora en una multiplicación, pero la calculadora no reemplaza al matemático. Un modelo que lee una imagen mejor que un especialista resuelve una de las muchas tareas que ese especialista realiza en un día. Su propia presentación lo formulaba con precisión: superioridad «en tareas aisladas, relacionadas con una imagen».
El siguiente salto fue la arquitectura transformer, publicada en 2017[5], que llevó a los grandes modelos de lenguaje. La transcripción de la charla sitúa el lanzamiento de ChatGPT en noviembre de 2021; la fecha correcta es el 30 de noviembre de 2022[6]. Con estos modelos llegó la idea de «modelo fundacional»: en lugar de entrenar un modelo para cada tarea con datos etiquetados, se entrena uno muy grande con datos no etiquetados mediante aprendizaje autosupervisado y luego se adapta a tareas distintas[7].
Esto abrió una pregunta que el ponente consideró sin resolver: ¿conviene usar un modelo general o uno médico especializado? En junio de 2026, un estudio publicado en Nature Medicine comparó tres modelos generales recientes con dos herramientas clínicas especializadas. Los modelos generales obtuvieron mejores resultados en preguntas tipo examen, en una prueba de concordancia con criterios de expertos y en cien consultas clínicas reales[8]. El hallazgo es relevante, pero conviene leerlo con dos cautelas. Una de las empresas evaluadas pidió la retractación del artículo por razones metodológicas. Y todas las pruebas miden calidad de respuestas, no resultados en pacientes.
Para tener presente
Decir que un modelo es «el mejor» solo tiene sentido si se especifica la tarea, la versión, la fecha y la prueba. Los rankings cambian en meses y miden cosas distintas.
3Del examen a la decisión clínica
Wong planteó como primera causa de la brecha que la mayoría de la IA médica no aborda la toma de decisiones clínicas del mundo real. Los modelos resuelven bien preguntas de selección múltiple con toda la información disponible desde el principio. En la práctica, el médico reúne datos por etapas, decide qué examen pedir, interpreta resultados ambiguos y actúa con información incompleta.
El estudio que mostró en ese punto ilustra la diferencia. Un equipo alemán construyó un escenario con 2.400 casos reales de dolor abdominal agudo, tomados de una base de datos hospitalaria pública. Cuando los modelos de lenguaje evaluados en 2024 tuvieron que decidir qué información solicitar, su exactitud diagnóstica cayó y quedó por debajo de la de los médicos. Además, eran sensibles al orden y a la cantidad de información recibida, y con frecuencia no seguían las instrucciones[9]. Los modelos de 2026 son más capaces que los de ese estudio, pero la pregunta de fondo sigue vigente: un buen resultado en un examen no demuestra buen desempeño en el flujo real.
La propia presentación incluyó una curva útil para ordenar la evidencia: pruebas de referencia, simulaciones, estudios de factibilidad en un centro y ensayos a escala nacional. Los trabajos más recientes de Google con su sistema conversacional AMIE recorren parte de esa curva. En una simulación con casos de seguimiento a lo largo de varias visitas, sus planes de manejo no fueron inferiores a los de 21 médicos de atención primaria[10]. Y en un estudio prospectivo de factibilidad, cien pacientes de una consulta de atención primaria urgente en Boston conversaron con el sistema antes de ver al médico, con supervisión humana y sin necesidad de detener ninguna conversación por seguridad[11]. Es un avance real, pero se trata de un solo centro, sin grupo de comparación y con supervisión estrecha. Desarrollamos esta escala de evidencia en el documento complementario.
4Por qué la IA no se ve en los hospitales
El ponente enumeró cuatro causas en su presentación. Además de la distancia entre examen y decisión, señaló que la tecnología llega empujada por las empresas, que los factores del paciente rara vez se consideran, que la confianza es insuficiente y que buena parte de la atención depende de conocimiento tácito, difícil de medir y de convertir en datos.
Sus dos ejemplos más sólidos son casos de implementación. El primero es el mismo algoritmo de retinopatía de 2016. Cuando Google lo llevó a once clínicas de atención primaria en Tailandia, un estudio observacional encontró que muchas fotografías eran rechazadas por mala calidad, que la conectividad retrasaba los resultados y que el proceso añadía trabajo al personal de enfermería[12]. El ponente lo presentó como un algoritmo que «no se usa», apoyándose en un artículo de prensa que habló de una prueba «fallida». La evidencia admite una lectura más precisa: en un estudio prospectivo posterior, dentro del programa nacional de cribado tailandés, el sistema mostró una exactitud comparable a la de especialistas en retina[13]. El problema inicial no fue de exactitud, sino de flujo de trabajo y contexto. Esa fue, justamente, la lección del ponente: llevar la IA a la práctica exige ciencia de la computación e ingeniería, y además comprender el contexto clínico y el flujo de trabajo.
El segundo ejemplo es probablemente el mejor argumento de toda la charla. En el ensayo TRICORDER, 205 consultorios de atención primaria del Reino Unido, con más de 1,5 millones de pacientes registrados, se asignaron al azar a usar un estetoscopio con IA capaz de detectar insuficiencia cardiaca, fibrilación auricular y valvulopatías, o a seguir con la atención habitual. A los doce meses, la detección de insuficiencia cardiaca no aumentó de forma significativa (razón de tasas de incidencia 0,94; intervalo de confianza del 95 %: 0,86 a 1,02). Sin embargo, en los pacientes efectivamente examinados con el dispositivo, la detección fue mayor[14].

El ponente lo resumió como una paradoja: una tecnología que funciona (eficacia) dentro de una intervención que fracasa (efectividad). Según su presentación, el 40 % dejó de usar el dispositivo antes de un año, y el sistema no escribía automáticamente en la historia clínica electrónica. Los investigadores atribuyeron la caída del uso a que el dispositivo añadía pasos a la consulta y no estaba bien integrado con la historia clínica[15]. No pudimos confirmar la cifra del 40 % en el resumen publicado del ensayo.
Conviene leer el resultado con exactitud. «Sin diferencia estadísticamente significativa» no equivale a «se demostró que no sirve» ni a «la herramienta es equivalente a no usarla». El ensayo mostró que poner el dispositivo a disposición de los consultorios no bastó para cambiar el indicador poblacional en doce meses. Para un gestor, esa es la información más útil: el efecto depende de la adopción, y la adopción depende del diseño del proceso.

Dos casos hospitalarios, que no se mencionaron en la conferencia, completan el cuadro. Un modelo de predicción de sepsis integrado en una historia clínica comercial muy difundida mostró, en una validación externa independiente, una capacidad de discriminación modesta: no identificó a dos de cada tres pacientes con sepsis, mientras generaba alertas para el 18 % de los hospitalizados[16]. En sentido contrario, un sistema de alerta temprana de deterioro en un hospital de Toronto se asoció con menos muertes no esperadas en medicina interna, en un estudio no aleatorizado. Su diseño incluyó algo más que el algoritmo: alertas en tiempo real, correos dos veces al día a enfermería, una ruta de atención para los pacientes de alto riesgo y comunicación con cuidados paliativos[17].
Las otras causas que enumeró el ponente apuntan en la misma dirección. Una revisión sistemática publicada en agosto de 2026 en Nature Health, de la que Wong es coautor, analizó 330 estudios de IA médica que evaluaron factores del paciente. La mayoría midió satisfacción y beneficios percibidos. La confianza (16,7 %) y la seguridad (10,9 %) se examinaron poco, y solo el 3,9 % consideró al paciente en las fases de diseño y desarrollo; casi todo ocurrió en la validación final[18]. A esto se suma que muchas decisiones clínicas se apoyan en información que no queda registrada, como la percepción del estado general del paciente o la conversación con la familia[19]. Un modelo solo puede aprender de lo que se mide.
5Modelos abiertos o cerrados: una decisión de gobierno
Wong dedicó parte de la charla a una disyuntiva que muchas instituciones enfrentarán pronto: trabajar con modelos propietarios, como los de OpenAI, Anthropic o Google, o con modelos de pesos abiertos, como los de las empresas chinas DeepSeek o Moonshot. Comparó a los primeros con los grandes proveedores de software clínico: se recibe la capacidad, pero no se ve cómo se construyó. Afirmó también que los modelos abiertos van de seis a doce meses por detrás y que para muchos países es razonable aceptar ese retraso a cambio de menor costo.
Tres precisiones ayudan a decidir mejor.
Pesos abiertos no es lo mismo que datos abiertos. En septiembre de 2025, Nature publicó el modelo de razonamiento DeepSeek-R1 tras revisión por pares, el primero de uso masivo en pasar por ese proceso[20]. El ponente lo presentó como el único revisado y afirmó que sus pesos y sus fuentes de datos están disponibles. Los pesos sí se pueden descargar, pero la empresa no publicó sus datos de entrenamiento, como reconoció la editora jefa de la revista en el texto con que anunció la publicación, que el propio ponente citó. Además, la revisión por pares de un modelo general no equivale a una validación clínica.
El retraso no es fijo. Según Epoch AI, desde enero de 2026 los mejores modelos de pesos abiertos han ido en promedio unos cuatro meses por detrás de los cerrados en su índice agregado de capacidades, frente a cerca de un año a principios de 2025[21]. Es un promedio sobre pruebas generales; para una tarea clínica concreta, la diferencia puede ser mayor, menor o inexistente.
No todos los proveedores entrenan con los datos del cliente. El ponente describió un escenario en el que el proveedor propietario exige compartir datos para entrenar su modelo. Ocurre en algunos acuerdos, pero no es la regla: las condiciones varían entre productos de consumo, acceso por interfaz de programación (API) y contratos empresariales. En sus servicios para empresas, los principales proveedores declaran que no entrenan con los datos del cliente por defecto. Lo que corresponde es leer el contrato, no suponer.
Desde la gestión de operaciones clínicas, la conclusión es que la elección no es ideológica. Depende de la tarea, del riesgo de error, de la capacidad técnica para alojar y mantener un modelo, del costo total y de las condiciones contractuales sobre datos, auditoría y salida. En el documento complementario proponemos cuatro decisiones para ordenarla.
6Agentes, modelos del mundo y robots: madurez distinta
La presentación terminó su recorrido técnico con tres tendencias. Conviene no tratarlas como equivalentes, porque están en etapas muy diferentes.
Sistemas agénticos. Son sistemas que no solo responden, sino que ejecutan pasos: consultan fuentes, programan tareas o interactúan con el paciente. El ponente advirtió sobre los agentes autónomos con acceso a calendarios, contraseñas y dispositivos. Una revisión publicada en The Lancet Digital Health en agosto de 2026, de la que es coautor, sostiene que su autonomía cambia el perfil de riesgo de la IA médica y que su utilidad dependerá de cómo se limite y supervise su capacidad de actuar[22].
Modelos del mundo. El ponente los definió como sistemas que aprenden cómo evoluciona un entorno y simulan estados futuros bajo distintas acciones, por ejemplo la evolución de un paciente con o sin tratamiento. Los presentó como la llegada de la medicina de precisión individual. Es una propuesta prometedora, pero hoy es investigación: no conocemos estudios prospectivos que demuestren que estas simulaciones mejoren decisiones clínicas. Tampoco deben confundirse con los gemelos digitales ni con los modelos predictivos clásicos, que estiman un riesgo sin simular intervenciones alternativas.
IA física y robótica. El ponente sostuvo que los robots quirúrgicos recogen datos durante las operaciones y que la próxima generación «aprenderá» del cirujano. La recolección de datos de video y cinemática es real y alimenta la investigación en autonomía quirúrgica. Pero no conocemos ningún sistema comercial autorizado que aprenda de forma continua durante la cirugía; un cambio así exigiría una nueva evaluación regulatoria.
Para una clínica colombiana, la prioridad no está en esta frontera. Está en que las herramientas maduras funcionen bien en sus procesos actuales.
7Las siete condiciones del ecosistema
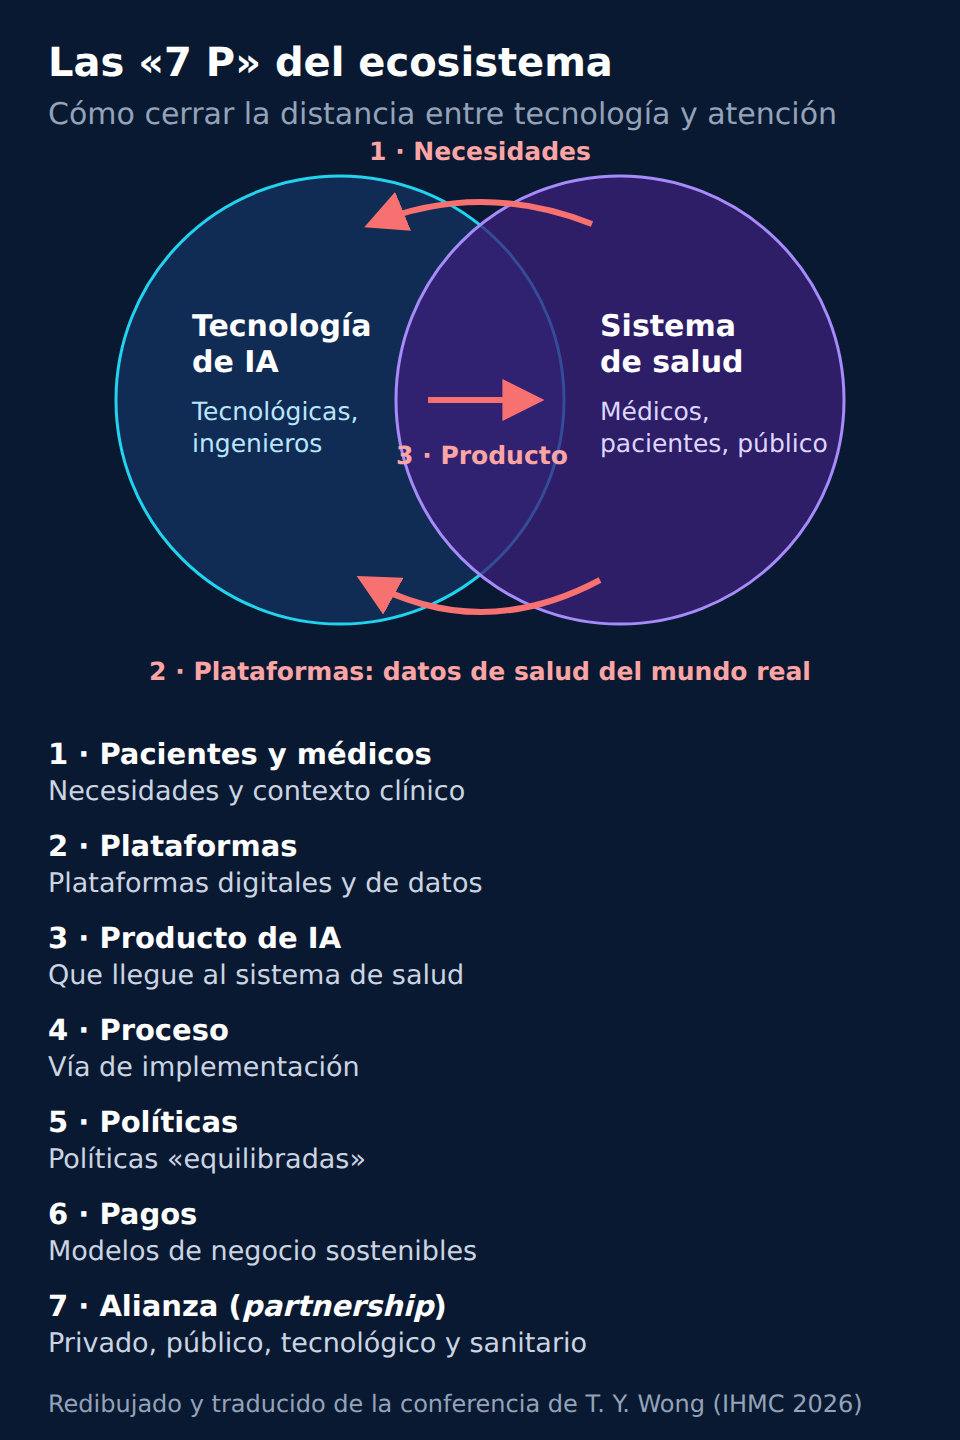
El cierre de la charla respondió a su pregunta inicial. Wong propuso un esquema que llamó las «7 P» del ecosistema de IA en medicina. La tecnología y el sistema de salud aparecen como dos mundos que apenas se tocan, conectados por un ciclo: las necesidades de pacientes y médicos deben orientar la tecnología, el producto debe llegar al sistema de salud y los datos del mundo real deben volver para mejorar los modelos.

Los siete elementos, tal como aparecieron en la presentación, son:
- Pacientes y médicos: sus necesidades y el contexto clínico.
- Plataformas: infraestructura digital y de datos.
- Producto: una herramienta de IA que llegue efectivamente al sistema de salud.
- Proceso: una vía de implementación.
- Políticas: «equilibradas», ni tan restrictivas que impidan avanzar ni tan laxas que pongan en riesgo a los pacientes.
- Pagos: modelos de negocio sostenibles, porque la IA no es gratuita.
- Alianza (partnership): colaboración entre los sectores privado, público, tecnológico y sanitario.
El esquema es más útil de lo que parece a primera vista, porque convierte la pregunta «¿qué IA compramos?» en una lista de condiciones previas. Si se traslada a una clínica, cinco de las siete P dependen de la propia institución: entender sus necesidades, tener plataformas de datos, diseñar procesos, financiar el servicio y gestionar alianzas. Solo el producto y buena parte de las políticas vienen de fuera.
8Hospital y ambulatorio: tres niveles de decisión
La conferencia no distinguió entre ámbitos de atención, pero sus casos tienen un sesgo claro: la retinopatía en Tailandia, el estetoscopio británico y el sistema conversacional de Boston ocurrieron en atención primaria o ambulatoria. La evidencia hospitalaria que citamos procede de otras fuentes. Por eso analizamos los dos ámbitos por separado: lo que respalda a uno no demuestra automáticamente la utilidad en el otro.
Esta sección es análisis editorial. Las propuestas no reproducen recomendaciones del ponente y los ejemplos son hipotéticos.
| Nivel | Clínica u hospital | Atención ambulatoria y cohortes |
|---|---|---|
| Estratégico: qué resultados buscamos | Priorizar problemas de oportunidad, capacidad y seguridad (flujo de urgencias, programación quirúrgica, deterioro en piso, egreso). Gobierno clínico y de datos. Criterios de inversión y de alianza. | Definir la población a cargo y sus prioridades de salud. Equidad y continuidad como objetivos. Articulación con la red hospitalaria y gobierno de datos poblacionales. |
| Táctico: cómo lo organizamos | Portafolio corto de casos de uso con línea de base. Rediseño del proceso antes de la herramienta. Integración con la historia clínica. Formación, validación local y plan de retiro. | Estratificación de riesgo ligada a programas con cupos reales. Agendas y equipos para el seguimiento proactivo. Rutas de referencia y contrarreferencia. |
| Operativo: qué cambia en el día a día | Quién recibe la alerta, en cuánto tiempo responde y cómo lo registra. Revisión humana de lo que el modelo escribe. Modo de contingencia si el sistema falla. | Listas de pendientes, contacto y cierre de brechas. Conciliación de medicamentos y de información. Escalamiento clínico y registro del resultado de cada contacto. |
En la clínica: capacidad, seguridad y carga documental
En el nivel estratégico, la dirección debería decidir qué problema asistencial quiere resolver antes de decidir qué herramienta comprar. En una clínica de mediana y alta complejidad, los candidatos suelen ser conocidos: la saturación de urgencias, la espera de cama, las cancelaciones quirúrgicas, el deterioro no detectado en hospitalización, los egresos tardíos y la carga documental del personal. La IA puede aportar en varios de ellos, pero no en todos con el mismo respaldo.
La documentación clínica asistida es el caso con evidencia más reciente. En un ensayo aleatorizado con 238 médicos ambulatorios de una red universitaria estadounidense, una de dos herramientas de escritura ambiental redujo el tiempo dedicado a las notas en un 9,5 % frente al grupo control, mientras que la otra no mostró una diferencia significativa. Ambas se asociaron con mejoras en indicadores de agotamiento, y los autores registraron errores clínicamente relevantes ocasionales que obligan a revisar cada nota[23]. Es evidencia ambulatoria; su traslado a la hospitalización requiere evaluación local.
En el nivel táctico, el caso de CHARTwatch enseña lo esencial: la alerta de deterioro funcionó como parte de un proceso, con destinatarios, horarios y una ruta de respuesta[17]. El caso del modelo de sepsis enseña lo contrario: una herramienta integrada en la historia clínica, sin validación local, puede generar muchas alertas y dejar pasar la mayoría de los casos[16]. Antes de encender un modelo predictivo, conviene medir su desempeño con datos propios y definir qué hará el equipo con cada alerta.
En el nivel operativo, la pregunta es concreta: quién recibe la alerta, cuánto tiempo tiene para responder, qué hace si no está de acuerdo y dónde queda registrado. También hay que decidir qué ocurre cuando el sistema no está disponible. Un servicio que depende de una herramienta de IA debe poder seguir funcionando sin ella.
Ejemplo hipotético
Una clínica decide usar un modelo para anticipar qué pacientes de hospitalización podrían egresar en las próximas 24 horas. Si solo publica la lista en un tablero, probablemente nada cambie. Si la lista llega a la reunión matutina de gestión de camas, cada caso tiene un responsable de verificar pendientes (laboratorios, interconsultas, fórmula, transporte) y se mide la hora real de egreso antes y después, el modelo puede convertirse en capacidad. El tiempo liberado solo se traduce en más oportunidad de atención si la cama se ocupa antes con un paciente que esperaba en urgencias.
Ese último punto merece énfasis. Ahorrar minutos no es un fin en sí mismo. El tiempo que libera una herramienta solo genera valor si la organización lo convierte en algo: más pacientes atendidos a tiempo, una revisión de seguridad que antes no se hacía, una conversación más larga con la familia o menos horas extra. Si no hay un plan para ese tiempo, suele diluirse.
En la atención ambulatoria: cohortes, continuidad y respuesta
La conferencia ofrece más respaldo directo a este ámbito. El cribado de retinopatía diabética es un caso típico de gestión de cohortes: hay una población definida, una prueba con buen desempeño y un objetivo claro. Las lecciones de Tailandia y del estetoscopio británico apuntan a lo mismo: el valor depende de la calidad de la captura, del flujo de trabajo y de que el resultado llegue a alguien que pueda actuar.
En el nivel estratégico, una red ambulatoria debería definir la población que tiene a cargo, sus prioridades de salud y los resultados que quiere mejorar: control de enfermedades crónicas, detección temprana, acceso efectivo y continuidad. La IA puede ayudar a caracterizar la población y a estratificar el riesgo, pero la equidad debe ser un objetivo explícito. Los modelos entrenados con datos de quienes más consultan tienden a ver menos a quienes menos acceden.

En el nivel táctico, la condición decisiva es que cada estrato de riesgo tenga un programa con capacidad real. Una lista de pacientes de alto riesgo cardiovascular que no se puede atender en las próximas semanas no mejora la salud de nadie; solo traslada trabajo y angustia. La predicción debe dimensionarse según la capacidad de respuesta, y no al revés.
En el nivel operativo, lo que cambia es cada contacto: quién revisa la lista, cómo se localiza a la persona, qué se le ofrece, cómo se concilian medicamentos e información entre especialistas y cómo se registra el cierre de cada brecha. Los sistemas conversacionales pueden apoyar la preparación de la consulta o el seguimiento entre visitas, pero hoy su evidencia se limita a factibilidad con supervisión estrecha[11].
Ejemplo hipotético
Una red de centros ambulatorios incorpora la lectura automática de fotografías de fondo de ojo para su cohorte de pacientes con diabetes. Antes de empezar define cuántas citas de oftalmología puede ofrecer cada mes a quienes resulten positivos, quién llama a cada paciente, qué ocurre con las imágenes que el sistema no puede leer y cómo se registra el resultado en la historia clínica. Mide la proporción de la cohorte cribada, el tiempo hasta la valoración oftalmológica y la proporción de imágenes no válidas por centro, no solo la exactitud del algoritmo.
La transición entre los dos ámbitos
El punto donde ambos ámbitos se encuentran es el egreso hospitalario. Allí se pierden con frecuencia la información, la conciliación de medicamentos y la cita de control. La IA puede ayudar a resumir la hospitalización, identificar a los pacientes con más riesgo de reingreso y organizar el seguimiento. Pero el beneficio depende de que la red ambulatoria reciba la información, tenga cupo para el control y sepa a quién llamar. Es un caso de uso que obliga a coordinar a dos organizaciones, y por eso exige acuerdos explícitos sobre datos, responsabilidades y tiempos.
El documento complementario desarrolla seis casos de uso, tres hospitalarios y tres ambulatorios, con su problema, objetivo, responsable, requisitos, supervisión, contingencia e indicadores.
9El marco colombiano: obligaciones y buenas prácticas
Ninguna de las experiencias citadas ocurrió en Colombia. Trasladarlas exige verificar al menos cuatro condiciones: que los datos locales tengan la calidad y la estructura que el modelo necesita; que el desempeño se mantenga en la población propia; que el proceso pueda rediseñarse con el personal y los contratos disponibles; y que exista financiación para sostenerlo.
Algunas condiciones son obligaciones legales:
- Los datos de salud son datos sensibles según el régimen general de protección de datos personales, lo que exige autorización, finalidad definida y medidas de seguridad[24].
- La historia clínica electrónica interoperable es obligatoria[25], y el conjunto de datos clínicos relevantes para la interoperabilidad está definido[26].
- La nueva reglamentación de telesalud y telemedicina permite usar IA solo como apoyo y bajo supervisión humana, sin sustituir el juicio clínico[27].
Otras son orientaciones de política pública. La Política Nacional de Inteligencia Artificial, adoptada en febrero de 2025, fija principios de uso ético y responsable, pero no establece por sí misma requisitos específicos para las instituciones de salud[28]. Y hay prácticas que ninguna norma exige todavía, pero que cualquier institución prudente debería adoptar: validar localmente, mantener un inventario de los modelos en uso, vigilar su desempeño y definir criterios para retirarlos.
10Cuánto invertir y en qué
El ponente afirmó que los hospitales deberían destinar entre el 15 % y el 20 % de su gasto operativo a tecnología y digitalización para estar preparados, a partir de una conversación con un antiguo colega de Singapur. Es una recomendación del ponente, no un estándar sectorial. Las referencias publicadas son muy inferiores: en Estados Unidos, el gasto en tecnología de la información de los hospitales se ha estimado en torno al 2,3 % del gasto operativo[29]. La cifra del ponente expresa una convicción sobre la magnitud del cambio, pero no debería trasladarse a un presupuesto sin un análisis propio.
Más útil que un porcentaje es contar el costo completo de cada caso de uso. Además de la licencia, incluye la integración con la historia clínica, la infraestructura, la validación local, la formación, el tiempo clínico dedicado a la supervisión, el monitoreo, el soporte, la ciberseguridad y el costo de salida si se cambia de proveedor. Con frecuencia, la licencia es la parte menor. Tampoco conviene prometer retornos financieros antes de medir: los beneficios de la IA suelen aparecer como capacidad, oportunidad o seguridad, y su traducción a dinero depende de cómo la institución use lo ganado.
11Limitaciones e incertidumbres
La conferencia fue una visión general, no una exposición de resultados propios. Varias de las publicaciones que el ponente citó tienen a Wong entre sus autores; no le resta valor, pero conviene saberlo. Contrastamos sus afirmaciones con fuentes independientes y corregimos o contextualizamos las que no se sostenían tal como se formularon. Omitimos una comparación entre la contaminación del Sudeste Asiático y el consumo de cigarrillos, porque las cifras de la transcripción no pudieron verificarse.
La evidencia sobre IA clínica cambia rápido. Los estudios de desempeño citados evaluaron versiones de modelos que ya han sido superadas, y los estudios de implementación son todavía pocos. La mayoría procede de países de ingresos altos. La evidencia hospitalaria que incluimos proviene de estudios observacionales o de un solo centro.
Por último, este artículo no presupone recursos, contratos ni capacidades de ninguna institución concreta. Los ejemplos son hipotéticos y las propuestas son un punto de partida para que cada equipo directivo las adapte a su contexto.
Para cerrar
La conferencia dejó una idea que vale más que cualquier lista de tecnologías: la IA ya es capaz; lo que falta es convertir esa capacidad en una intervención que funcione dentro de la organización.
Estratégico. La dirección debería elegir pocos problemas asistenciales que importen, con un responsable y una línea de base, y gobernar la IA como se gobierna un medicamento o un equipo médico: con evidencia, vigilancia y criterios de retiro.
Táctico. Los programas deberían rediseñar el proceso antes de instalar la herramienta, integrarla en la historia clínica, validarla con datos propios y asegurar que cada alerta tenga una respuesta posible.
Operativo. Los equipos deberían saber quién actúa, en qué plazo, cómo se registra y qué hacer cuando el sistema falla, y medir el uso, los errores, la carga de trabajo y el resultado.
Desde la gestión de operaciones clínicas, la prioridad no es tener más IA, sino lograr que la que se adopte cambie algo medible para los pacientes.
Referencias
- Frenk J, Chen L, Bhutta ZA, et al. Health professionals for a new century: transforming education to strengthen health systems in an interdependent world. Lancet. 2010;376(9756):1923-1958. doi:10.1016/S0140-6736(10)61854-5.
- Hood CM, Gennuso KP, Swain GR, Catlin BB. County Health Rankings: relationships between determinant factors and health outcomes. Am J Prev Med. 2016;50(2):129-135. PubMed.
- Gulshan V, Peng L, Coram M, et al. Development and validation of a deep learning algorithm for detection of diabetic retinopathy in retinal fundus photographs. JAMA. 2016;316(22):2402-2410. doi:10.1001/jama.2016.17216.
- Ting DSW, Cheung CY, Lim G, et al. Development and validation of a deep learning system for diabetic retinopathy and related eye diseases using retinal images from multiethnic populations with diabetes. JAMA. 2017;318(22):2211-2223. doi:10.1001/jama.2017.18152.
- Vaswani A, Shazeer N, Parmar N, et al. Attention is all you need. Advances in Neural Information Processing Systems 30 (NeurIPS 2017). arXiv:1706.03762.
- OpenAI. Introducing ChatGPT. 30 de noviembre de 2022. Anuncio.
- Bommasani R, Hudson DA, Adeli E, et al. On the opportunities and risks of foundation models. Stanford CRFM; 2021. arXiv:2108.07258.
- Vishwanath K, et al. General-purpose large language models outperform specialized clinical AI tools on medical benchmarks. Nat Med. Publicado en línea el 12 de junio de 2026. doi:10.1038/s41591-026-04431-5.
- Hager P, Jungmann F, Holland R, et al. Evaluation and mitigation of the limitations of large language models in clinical decision-making. Nat Med. 2024;30(9):2613-2622. doi:10.1038/s41591-024-03097-1.
- Liévin V, Palepu A, Weng WH, et al. Towards conversational artificial intelligence for disease management. Nature. 2026. doi:10.1038/s41586-026-10764-5.
- Brodeur PG, Koshy JM, Palepu A, et al. Conversational diagnostic artificial intelligence in ambulatory primary care: a prospective feasibility study. Lancet. Publicado en línea el 8 de octubre de 2026. Versión preliminar en arXiv:2603.08448.
- Beede E, Baylor E, Hersch F, et al. A human-centered evaluation of a deep learning system deployed in clinics for the detection of diabetic retinopathy. Proceedings of the 2020 CHI Conference on Human Factors in Computing Systems. 2020:1-12. doi:10.1145/3313831.3376718.
- Ruamviboonsuk P, Tiwari R, Sayres R, et al. Real-time diabetic retinopathy screening by deep learning in a multisite national screening programme: a prospective interventional cohort study. Lancet Digit Health. 2022;4(4):e235-e244. doi:10.1016/S2589-7500(22)00017-6.
- Kelshiker MA, Bächtiger P, Petri CF, et al. Triple cardiovascular disease detection with an artificial intelligence-enabled stethoscope (TRICORDER) in the UK: a cluster-randomised controlled implementation trial. Lancet. 2026;407(10529):704-715. PubMed.
- Imperial College London. AI-enabled stethoscopes show promise for improving diagnosis of cardiovascular conditions, UK trial finds. Nota de prensa; enero de 2026. Nota.
- Wong A, Otles E, Donnelly JP, et al. External validation of a widely implemented proprietary sepsis prediction model in hospitalized patients. JAMA Intern Med. 2021;181(8):1065-1070. doi:10.1001/jamainternmed.2021.2626.
- Verma AA, Stukel TA, Colacci M, et al. Clinical evaluation of a machine learning-based early warning system for patient deterioration. CMAJ. 2024;196(30):E1027-E1037. doi:10.1503/cmaj.240132.
- Lai S, Guan Z, Zhang Y, et al. Patient factors in medical artificial intelligence: a systematic review. Nature Health. Publicado en línea el 26 de agosto de 2026. Artículo.
- Yu KH, Healey E, Leong TY, Kohane IS, Manrai AK. Medical artificial intelligence and human values. N Engl J Med. 2024;390(20):1895-1904. doi:10.1056/NEJMra2214183.
- Guo D, Yang D, Zhang H, et al. DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature. 2025;645:633-638. doi:10.1038/s41586-025-09422-z.
- Edwards J, Emberson L. Brecha entre modelos de pesos abiertos y cerrados en el Epoch Capabilities Index. Epoch AI, Data Insight; mayo de 2026. Análisis.
- Qin Y, Zeng D, Ma W, et al. Autonomous agentic artificial intelligence systems in health care: friend or foe? Lancet Digit Health. Publicado en línea el 29 de agosto de 2026. doi:10.1016/j.landig.2026.101073.
- Ambient AI scribes in clinical practice: a randomized trial. NEJM AI. 2025. PubMed.
- Congreso de la República de Colombia. Ley Estatutaria 1581 de 2012, por la cual se dictan disposiciones generales para la protección de datos personales. Texto en Función Pública.
- Congreso de la República de Colombia. Ley 2015 de 2020, por medio de la cual se crea la historia clínica electrónica interoperable. Texto en Función Pública.
- Ministerio de Salud y Protección Social; Ministerio de Tecnologías de la Información y las Comunicaciones. Resolución 866 de 2021 (25 de junio), conjunto de elementos de datos clínicos relevantes para la interoperabilidad de la historia clínica. Texto en el normograma de la Supersalud.
- Ministerio de Salud y Protección Social de Colombia. Resolución 1644 de 2026 (31 de julio), sobre telesalud y telemedicina. Comunicado oficial.
- Departamento Nacional de Planeación. Documento CONPES 4144: Política Nacional de Inteligencia Artificial. Bogotá; 14 de febrero de 2025. PDF.
- Definitive Healthcare. Average IT expenses for US hospitals. Healthcare Insights. Análisis.
Eficacia frente a efectividad
Funciona en la prueba, no siempre en la consulta
Kelshiker et al. The Lancet, 2026. Presentado en la IHMC 2026.
Benchmarks
Aprobar el examen no es decidir
Los modelos superan el 90 % en preguntas tipo examen. Cuando deben pedir e interpretar la información de un caso real, su exactitud cae y quedan por debajo de los médicos.
Hager et al. Nature Medicine, 2024 (2.400 casos de abdomen agudo).
Las «7 P» de la conferencia
Cinco de siete dependen de la institución
T. Y. Wong, IHMC 2026. Clasificación interna/externa: análisis editorial.
Tres precisiones
Pesos abiertos no es datos abiertos
DeepSeek-R1 pasó revisión por pares en Nature, pero no publicó sus datos de entrenamiento. En 2026 los modelos abiertos fueron unos cuatro meses por detrás de los cerrados en un índice general. Para una tarea clínica, solo vale la prueba local.
Nature, 2025; Epoch AI, 2026.
Predecir no es intervenir
Una lista de riesgo sin respuesta traslada trabajo
Propuesta editorial a partir de la conferencia de la IHMC 2026.